
17 · Atención multicabeza
Estudio a fondo 17 de Tensores para Aprendizaje Automático. Una pregunta sobre ejes:
¿Cómo das a cada cabeza de atención su propio eje sin perder de vista qué token es cuál?
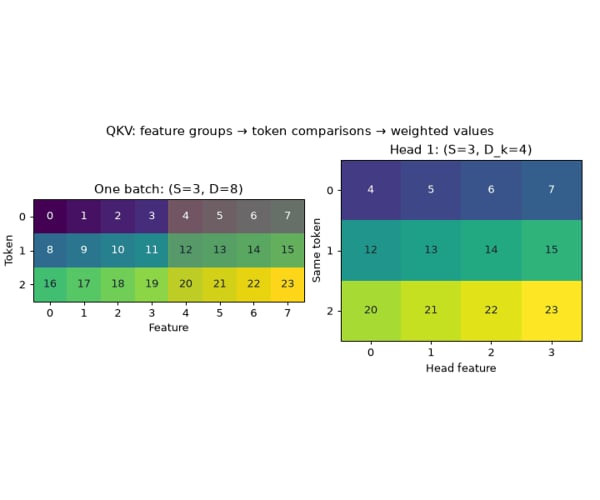
Sigue cada token de (B, S, D) a (B, H, S, D_k), calcula las puntuaciones, normaliza sobre las claves y vuelve a unir las cabezas. Necesita exactamente dos movimientos que ya conoces: el reshape y el transpose de la sección 04 y la contracción de la sección 06.
Y tiene una trampa que vale todo el laboratorio: un reshape directo da exactamente la forma correcta y las cabezas equivocadas.
En el taller de seis horas es el primer laboratorio en vivo: 25 minutos antes del almuerzo, trabajando la ruta esencial hasta «Core complete». El resto queda para casa.
Estudia aquí y luego ejecuta lo real: cuaderno 17 en Colab · todos los cuadernos · el escenario de atención en la página interactiva
Creado a partir del material del propio taller, de Ravi Kalia y Sebastian Laverde Chunza, CC BY 4.0.
Tu ruta en esta unidad
Paso 1 de 3
Repaso inicial
Echa un primer vistazo a cada tema y marca Entendido cuando tengas la idea general.